Copertina tridimensionale del libro Algoritmi e Strutture Dati in TypeScript
ProgrammazioneAlgoritmiTypeScript

Algoritmi e Strutture Dati in TypeScript

Perché non basta saper scrivere codice.

Un percorso pratico e completo per comprendere, progettare e implementare algoritmi efficienti e strutture dati fondamentali, con un approccio moderno e orientato al codice reale.

di Davide D'Antonio

Codice reale

Tutti gli esempi sono scritti in TypeScript.

Approccio pratico

Dalla teoria all’implementazione.

Analisi della complessità

Impara a scrivere codice efficiente.

Pensa da sviluppatore

Costruisci basi solide per il futuro.

Cosa troverai nel libro

Array e stringhe
Liste concatenate
Stack e queue
Hash map e set
Heap e priority queue
Alberi binari
Trie
Grafi
Ordinamenti
Ricerca binaria
Divide et impera
Algoritmi greedy
Programmazione dinamica
Pattern da colloquio

Uno sguardo all’interno

Spiegazioni chiare, esempi concreti e illustrazioni originali per imparare davvero.
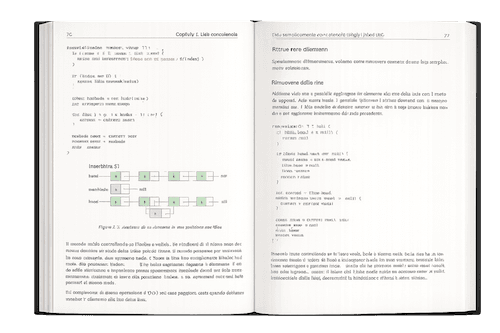
Pagina dedicata alle liste concatenate

Liste concatenate

Strutture dati spiegate attraverso diagrammi e codice.
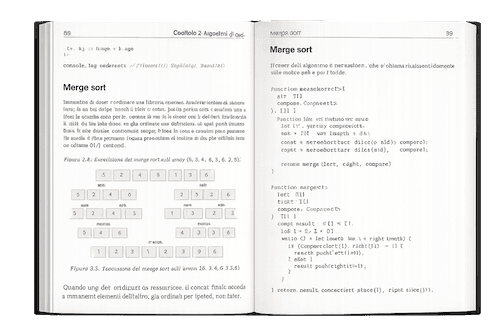
Pagina dedicata al merge sort

Ordinamento: Merge Sort

Ogni passaggio dell’algoritmo viene visualizzato.
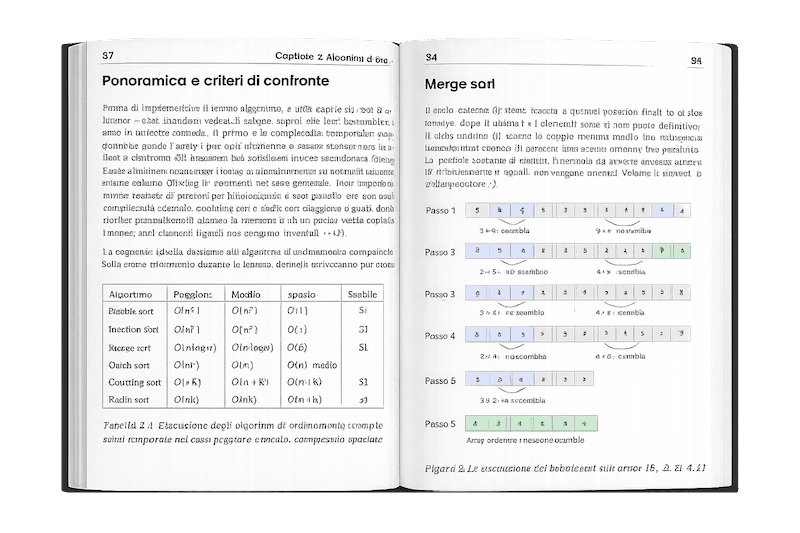
Tabella delle complessità algoritmiche

Analisi della complessità

Confronti immediati tra algoritmi e operazioni.

25Capitoli
80+Algoritmi ed esempi
300+Esempi di codice
100+Illustrazioni e diagrammi
600+Pagine

Cosa imparerai in questo libro

25 capitoli e 3 appendici, organizzati in 7 parti: da un ripasso di TypeScript fino alla preparazione di un colloquio tecnico.

Parte I — Le fondamenta

1TypeScript in pilloleLe basi di TypeScript necessarie per affrontare il libro: tipi, interfacce, generics e configurazione del progetto.
  • Perché TypeScript per gli algoritmi — Perché scegliere TypeScript invece di JavaScript puro per studiare algoritmi e strutture dati.
  • Tipi primitivi e annotazioni di tipo — I tipi di base del linguaggio e come annotare esplicitamente variabili e funzioni.
  • Interfacce e tipi personalizzati — Come definire contratti e forme dei dati con interface e type.
  • Generics: scrivere strutture dati flessibili e riutilizzabili — Come usare i generics per scrivere strutture dati che funzionano con qualsiasi tipo.
  • null e undefined: gestire l'assenza di valori — Strict null checks, narrowing e operatori per gestire i valori assenti in sicurezza.
  • Enumerazioni e unioni di tipi — Union type, tipi letterali ed enum per modellare insiemi di valori possibili.
  • Configurare il progetto TypeScript — Come inizializzare un progetto, installare TypeScript e configurare il tsconfig.json.
  • Conclusioni — Riepilogo dei concetti TypeScript che useremo in tutto il libro.
2Analisi della complessità: Big-OCome misurare il costo in tempo e spazio di un algoritmo con la notazione Big-O.
  • La notazione Big-O — Cos'è la notazione Big-O e perché serve per confrontare algoritmi.
  • Concetti fondamentali di Big-O — Le complessità più comuni, da O(1) a O(n log n), con esempi pratici.
  • Complessità spaziale: la memoria conta — Come stimare e confrontare lo spazio in memoria usato da un algoritmo.
  • Le regole della notazione Big-O — Le regole pratiche per semplificare un'espressione di complessità.
  • Conclusioni — Sintesi di come applicare Big-O per valutare un algoritmo.
  • Esercizi — Esercizi pratici per allenarti a calcolare la complessità.

Parte II — Strutture dati fondamentali

3Array e StringheCome funzionano array e stringhe in JavaScript/TypeScript, le loro complessità e le tecniche più usate per risolverli.
  • Array in JavaScript — Come il motore V8 rappresenta internamente gli array e cosa comporta in termini di prestazioni.
  • Array statici e dinamici — La differenza tra array a dimensione fissa e array che crescono dinamicamente.
  • Gli array tipizzati in JavaScript — TypedArray, ArrayBuffer e DataView per lavorare con memoria grezza.
  • Operazioni fondamentali e le loro complessità — Accesso, modifica, ricerca e inserimento su un array, con la relativa complessità.
  • Two pointers: la tecnica base per problemi su array — Come risolvere problemi su array ordinati con due puntatori che si muovono insieme.
  • Sliding Window — La tecnica della finestra scorrevole per problemi su sottoarray contigui.
  • Prefix sum — Come precalcolare somme cumulative per rispondere velocemente a query su intervalli.
  • Problemi classici e tecniche complementari — Anagrammi, duplicati e rotazioni: problemi ricorrenti sugli array.
  • Quando un array e quando no — Come capire quando un array è la struttura dati giusta da usare.
  • Conclusioni — Riepilogo delle tecniche fondamentali per lavorare con array e stringhe.
  • Esercizi — Esercizi pratici sulle tecniche viste nel capitolo.
4Liste concatenateNodo, puntatore e le tre varianti di lista concatenata: singola, doppia e circolare.
  • L'importanza delle liste concatenate — Perché le liste concatenate restano una struttura dati fondamentale da conoscere.
  • Concetto di nodo e puntatore in TypeScript — Come rappresentare nodo e riferimento all'elemento successivo in TypeScript.
  • L'interfaccia della lista concatenata — Il contratto comune che useremo per tutte le implementazioni di lista.
  • Lista semplicemente concatenata (Singly Linked List) — Aggiunta, rimozione, ricerca e inversione con un solo collegamento per nodo.
  • Lista doppiamente concatenata (Doubly Linked List) — Le stesse operazioni con un collegamento anche al nodo precedente.
  • Lista circolare (Circular Linked List) — Una lista in cui l'ultimo nodo torna al primo, con le sue operazioni tipiche.
  • Conclusioni — Confronto tra le varianti di lista concatenata e quando usarle.
  • Esercizi — Esercizi pratici sulle liste concatenate.
5Pile (Stack)Il principio LIFO, due implementazioni a confronto e i problemi classici basati sullo stack.
  • Il principio LIFO — Cos'è uno stack e alcuni esempi reali del principio last-in first-out.
  • Definizione dell'interfaccia — Il contratto comune push, pop e peek che implementeremo.
  • Implementazione con array — Come realizzare uno stack sopra un array.
  • Implementazione con lista concatenata — Come realizzare uno stack sopra una lista concatenata.
  • Call Stack: come JavaScript usa lo stack internamente — Come il motore JavaScript usa lo stack per gestire le chiamate a funzione.
  • Problemi classici — Parentesi bilanciate, reverse di stringa e conversione infix/postfix.
  • Monotonic Stack — La tecnica dello stack monotono per problemi come Daily Temperatures.
  • Conclusioni — Riepilogo di quando e come usare uno stack.
  • Esercizi — Esercizi pratici sullo stack.
6Code (Queue)Il principio FIFO, code circolari, deque e un'introduzione alle code a priorità.
  • Il concetto FIFO — Cos'è una coda e alcuni esempi reali del principio first-in first-out.
  • Definizione dell'interfaccia — Il contratto comune enqueue e dequeue che implementeremo.
  • Implementazione con array — Come realizzare una coda sopra un array e il problema dello spazio sprecato.
  • Implementazione con array dinamici — Una variante che gestisce la crescita dell'array sottostante.
  • Implementazione con lista concatenata — Come realizzare una coda sopra una lista concatenata.
  • Code circolari — Come riutilizzare lo spazio dell'array con una coda circolare.
  • Deque (double-ended queue) — Una coda che permette inserimento e rimozione da entrambi gli estremi.
  • Introduzione alle code a priorità (Priority Queue) — Un primo sguardo alle code a priorità e alle loro applicazioni reali.
  • Conclusioni — Riepilogo delle varianti di coda e dei loro utilizzi.
  • Esercizi — Esercizi pratici sulle code.
7Hash map e hash setCome funziona l'hashing, la gestione delle collisioni e l'implementazione di una hash map da zero.
  • Il concetto di hashing — Come una funzione di hash trasforma una chiave in un indice.
  • Collisioni e gestione delle collisioni — Chaining e open addressing: le due strategie per gestire le collisioni.
  • Implementare una hash map da zero — Costruire una hash map completa: inserimento, ricerca, rimozione e resize.
  • Map e Set in JavaScript — Le strutture native Map e Set e quando preferirle a un oggetto.
  • Problemi classici — Two Sum, Group Anagrams e LRU Cache risolti con le hash map.
  • Quando la hash map è la risposta giusta — I segnali che indicano che una hash map è la struttura giusta da usare.
  • Conclusioni — Riepilogo di hashing, collisioni e hash map.
  • Esercizi — Esercizi pratici sulle hash map.
8RicorsioneCome pensare in modo ricorsivo, il call stack, memoization e tail recursion.
  • Come pensare in modo ricorsivo — I due ingredienti di ogni funzione ricorsiva e un template universale.
  • Il call stack e la ricorsione: cosa succede davvero — Cosa accade davvero nello stack a ogni chiamata ricorsiva, discesa e risalita.
  • I limiti della ricorsione: stack overflow e complessità — Il rischio di stack overflow e la complessità nascosta della ricorsione.
  • Memoization: evitare il lavoro già fatto — Come salvare i risultati già calcolati per evitare lavoro ripetuto.
  • Tail recursion e ottimizzazioni — La tail call optimization e quando conviene convertire la ricorsione in un ciclo.
  • Conclusioni — Riepilogo di quando e come usare la ricorsione.
  • Esercizi — Esercizi pratici sulla ricorsione.

Parte III — Strutture dati ad albero

9Alberi BinariTerminologia, attraversamenti in profondità e in ampiezza e i problemi classici sugli alberi binari.
  • Terminologia: nodi, radici, foglie, altezza, profondità — Il vocabolario di base per parlare di alberi: nodo, radice, foglia, altezza.
  • Implementazione in TypeScript — Come rappresentare un albero binario e costruirne uno in TypeScript.
  • Attraversamenti in profondità: preorder, inorder, postorder — I tre ordini di visita in profondità di un albero binario.
  • Attraversamento in ampiezza (BFS) — Come visitare un albero livello per livello usando una coda.
  • Problemi classici: altezza, simmetria, percorsi — Calcolare l'altezza, verificare la simmetria e trovare percorsi con somma target.
  • Il pattern ricorsivo che si ripete — Il pattern comune che ricorre in quasi tutti i problemi sugli alberi.
  • Conclusioni — Riepilogo degli attraversamenti e dei pattern sugli alberi binari.
  • Esercizi — Esercizi pratici sugli alberi binari.
10Alberi binari di ricerca (BST)La proprietà BST, inserimento e cancellazione, e gli alberi autobilancianti AVL e Red-Black.
  • La proprietà BST — La proprietà che rende un albero binario di ricerca efficiente.
  • Inserimento e cancellazione — Come inserire e rimuovere nodi mantenendo la proprietà BST.
  • BST bilanciato vs sbilanciato — Perché un BST sbilanciato può degradare le prestazioni a O(n).
  • Problemi classici: validazione, k-esimo elemento, LCA — Validare un BST, trovare il k-esimo elemento e il minimo antenato comune.
  • Albero AVL — Il primo albero autobilanciante: fattore di bilanciamento e rotazioni.
  • Albero Red-Black — Un albero autobilanciante alternativo, con proprietà e rotazioni diverse.
  • Conclusioni — Confronto tra BST, AVL e Red-Black e quando scegliere quale.
  • Esercizi — Esercizi pratici sui BST.
11Heap e Priority QueueMax-heap e min-heap, insert/extract/heapify, heap sort e la Priority Queue come astrazione.
  • Il concetto di heap: max-heap e min-heap — Le proprietà che definiscono un heap e la differenza tra max e min-heap.
  • Rappresentazione con array — Come rappresentare un heap in modo compatto usando un array.
  • Insert, extract e heapify — Sift up, sift down e come costruire uno heap in tempo lineare.
  • Implementazione completa in TypeScript — Una classe MaxHeap completa, con un esempio applicativo.
  • Heap sort — Come ordinare un array in-place sfruttando la struttura di uno heap.
  • Problemi classici — I k elementi più grandi e il merge di k liste ordinate.
  • Priority Queue come astrazione — Separare l'interfaccia PriorityQueue dalla sua implementazione con un heap.
  • Conclusioni — Riepilogo di heap, heap sort e code a priorità.
  • Esercizi — Esercizi pratici sugli heap.
12TrieUna struttura ad albero pensata per la ricerca efficiente su stringhe, con le sue applicazioni reali.
  • Il problema della ricerca su stringhe — Perché hash map e BST non sono ideali per certi problemi su stringhe.
  • Implementazione completa del trie — Costruire un trie completo con insert, search e startsWith.
  • Applicazioni del trie — Autocompletamento e controllo ortografico come casi d'uso reali del trie.
  • Complessità a confronto con hash map — Come si confrontano tempo e spazio del trie rispetto a una hash map.
  • Conclusioni — Riepilogo di quando il trie è la struttura dati giusta.
  • Esercizi — Esercizi pratici sul trie.

Parte IV — Grafi

13Introduzione ai GrafiTerminologia dei grafi, rappresentazioni in memoria e come riconoscere un problema su grafi.
  • Terminologia: vertici, archi e grafi orientati — Vertici, archi, grado, percorsi, cicli e connettività: il vocabolario dei grafi.
  • Grafi pesati — Grafi in cui ogni arco ha un costo o un peso associato.
  • Rappresentazioni in memoria — Lista di adiacenza e matrice di adiacenza a confronto.
  • Implementazione in TypeScript — Come implementare grafo non orientato, orientato e pesato in TypeScript.
  • Quando un problema è un problema su grafi — Come riconoscere che un problema si modella naturalmente con un grafo.
  • Conclusioni — Riepilogo dei concetti base sui grafi.
  • Esercizi — Esercizi pratici sui grafi.
14Algoritmi di VisitaDFS, BFS, rilevamento di cicli, componenti connesse e ordinamento topologico.
  • Depth-First Search (DFS) — Come esplorare un grafo in profondità, in versione ricorsiva e iterativa.
  • Breadth-First Search (BFS) — Come esplorare un grafo in ampiezza usando una coda, livello per livello.
  • Rilevamento di cicli — Come individuare cicli in grafi orientati e non orientati.
  • Componenti connesse — Trovare i gruppi di vertici connessi tra loro con una visita DFS.
  • Topological sort — L'algoritmo di Kahn per ordinare i vertici di un grafo aciclico orientato.
  • Problemi classici: isole, labirinti, dipendenze — Contare le isole, uscire da un labirinto e risolvere grafi di dipendenze.
  • Conclusioni — Riepilogo di DFS, BFS e dei loro utilizzi.
  • Esercizi — Esercizi pratici sugli algoritmi di visita.
15Shortest PathIl problema del cammino minimo, dall'uso di BFS fino a Dijkstra e Bellman-Ford.
  • Il problema del cammino minimo — Perché BFS non basta quando gli archi hanno un peso.
  • BFS per grafi non pesati — Come usare BFS per trovare il cammino minimo su grafi non pesati.
  • Algoritmo di Dijkstra — Il cammino minimo su grafi con pesi non negativi.
  • Bellman-Ford — Un algoritmo più generale, capace di gestire pesi negativi e rilevare cicli negativi.
  • Implementazioni in TypeScript — Un grafo pesato orientato completo, con un esempio end-to-end.
  • Conclusioni — Confronto tra gli algoritmi di cammino minimo visti nel capitolo.
  • Esercizi — Esercizi pratici sul cammino minimo.

Parte V — Algoritmi

16Algoritmi di OrdinamentoDai semplici bubble e insertion sort fino a merge sort, quick sort e agli ordinamenti lineari.
  • Panoramica e criteri di confronto — I criteri per confrontare algoritmi di ordinamento: tempo, spazio, stabilità.
  • Bubble sort e insertion sort — Due algoritmi semplici e il loro funzionamento passo per passo.
  • Merge sort — Un ordinamento stabile basato su divide et impera, con complessità O(n log n).
  • Quick sort — Un ordinamento in-place basato sul partizionamento attorno a un pivot.
  • Counting sort e radix sort — Due algoritmi di ordinamento non basati su confronto, lineari in certi casi.
  • Array.sort() in JavaScript — Come funziona davvero il metodo sort nativo e la trappola del comparatore.
  • Conclusioni — Confronto riassuntivo tra tutti gli algoritmi di ordinamento visti.
  • Esercizi — Esercizi pratici sugli ordinamenti.
17Ricerca binariaCome dimezzare lo spazio di ricerca, le sue varianti e i problemi classici che la sfruttano.
  • Dimezzare lo spazio di ricerca — L'idea alla base della ricerca binaria su un array ordinato.
  • Implementazione ricorsiva — Come implementare la ricerca binaria in versione ricorsiva.
  • Varianti: lower bound e upper bound — Trovare il primo o l'ultimo elemento che soddisfa una condizione.
  • Ricerca binaria sulla risposta — Come applicare la ricerca binaria non su un array ma su uno spazio di risposte.
  • Problemi classici — Ricerca in array ruotato, elemento di picco, radice quadrata intera.
  • Conclusioni — Riepilogo di quando e come applicare la ricerca binaria.
  • Esercizi — Esercizi pratici sulla ricerca binaria.
18BacktrackingScegli, esplora, annulla: come costruire soluzioni esplorando un albero di decisioni con pruning.
  • Il concetto: scegli, esplora, annulla — Il pattern base del backtracking, illustrato con le permutazioni.
  • L'albero delle decisioni — Come visualizzare le scelte di un problema come un albero da esplorare.
  • Pruning: potare rami inutili — Come tagliare i rami dell'albero delle decisioni che non porteranno a una soluzione.
  • Problemi classici — N-queens e sudoku solver risolti con il backtracking.
  • Conclusioni — Riepilogo di quando il backtracking è la tecnica giusta.
  • Esercizi — Esercizi pratici sul backtracking.

Parte VI — Tecniche avanzate

19Divide et ImperaIl paradigma divide et impera, il Master Theorem e applicazioni come Karatsuba.
  • Il paradigma — L'idea di dividere un problema in sottoproblemi più piccoli e ricomporne le soluzioni.
  • Il Master Theorem — Come calcolare la complessità di un algoritmo ricorsivo divide et impera.
  • Applicazioni: merge sort, quick sort, ricerca binaria — Come merge sort, quick sort e ricerca binaria siano tutti divide et impera.
  • Karatsuba multiplication — Un algoritmo di moltiplicazione di grandi numeri più veloce di quello scolastico.
  • Conclusioni — Riepilogo del paradigma divide et impera e delle sue applicazioni.
  • Esercizi — Esercizi pratici sul divide et impera.
20Programmazione dinamicaCome riconoscere un problema di DP, memoization e tabulation, e i pattern classici come knapsack, LCS e LIS.
  • Riconoscere un problema di programmazione dinamica — Sottostruttura ottimale e sottoproblemi sovrapposti: i segnali da riconoscere.
  • Memoization: top-down — L'approccio top-down: ricorsione con cache dei risultati già calcolati.
  • Tabulation: bottom-up — L'approccio bottom-up: costruire la soluzione partendo dai sottoproblemi più piccoli.
  • Identificare la sottostruttura ottimale e i sottoproblemi sovrapposti — Un metodo pratico in tre passi per impostare una soluzione di programmazione dinamica.
  • Pattern classici: 1D DP, 2D DP, knapsack, LCS, LIS — I pattern ricorrenti della programmazione dinamica, con esempi risolti.
  • Conclusioni — Riepilogo di memoization, tabulation e dei pattern di programmazione dinamica.
  • Esercizi — Esercizi pratici sulla programmazione dinamica.
21Algoritmi GreedyQuando una scelta localmente ottima porta alla soluzione globale: interval scheduling, Huffman e MST.
  • Quando il greedy funziona — Le condizioni che garantiscono la correttezza di un algoritmo greedy.
  • La proprietà greedy choice — Come dimostrare la correttezza di un algoritmo greedy con l'exchange argument.
  • Problemi classici: interval scheduling, Huffman, MST — Interval scheduling, codifica di Huffman e minimum spanning tree con Kruskal e Prim.
  • Conclusioni — Riepilogo di quando la strategia greedy è quella giusta.
  • Esercizi — Esercizi pratici sugli algoritmi greedy.
22Strategie di CachingLe politiche di cache LRU e LFU, con applicazioni reali in Node.js e nel browser.
  • LRU Cache — Come implementare una cache Least Recently Used combinando hash map e lista.
  • LFU Cache — Come implementare una cache Least Frequently Used con bucket per frequenza.
  • Applicazioni reali in Node.js e browser — Dove si nasconde il caching: cache dei moduli, Redis e cache del browser.
  • Conclusioni — Riepilogo delle strategie di caching e di quando usarle.
  • Esercizi — Esercizi pratici sulle strategie di caching.
23Ricerca su StringheDalla ricerca naive fino a KMP e Rabin-Karp, con le applicazioni pratiche del pattern matching.
  • Naive search: O(n·m) — L'approccio più semplice alla ricerca di un pattern in una stringa.
  • KMP (Knuth-Morris-Pratt) — Come evitare confronti ripetuti sfruttando la funzione di fallimento LPS.
  • Rabin-Karp e rolling hash — Come usare un hash che si aggiorna in tempo costante per cercare un pattern.
  • Applicazioni pratiche — Dove si usa il pattern matching: strumenti da riga di comando, bioinformatica, editor.
  • Conclusioni — Confronto tra gli algoritmi di ricerca su stringhe visti nel capitolo.
  • Esercizi — Esercizi pratici sulla ricerca su stringhe.

Parte VII — Preparazione ai Colloqui

24Come affrontare un problema algoritmicoIl framework UMPIRE per affrontare un problema di coding interview in modo strutturato.
  • Il framework UMPIRE — Understand, Match, Plan, Implement, Review, Evaluate: le sei fasi per risolvere un problema.
  • Comunicare il proprio ragionamento — Come spiegare ad alta voce il proprio ragionamento durante un colloquio tecnico.
  • Casi limite — Come individuare e gestire i casi limite di un problema.
  • Ottimizzare la soluzione in modo incrementale — Come partire da una soluzione naive e migliorarla passo dopo passo.
  • Conclusioni — Riepilogo del framework UMPIRE per i colloqui tecnici.
25Il viaggio continuaUn capitolo di chiusura con spunti su come continuare a crescere come sviluppatore dopo il libro.

Appendici

AComplessità a colpo d'occhioUna tabella di riferimento rapido con le complessità di tutte le strutture dati e gli algoritmi del libro.
  • Notazione — Il significato dei simboli O, Θ e Ω usati nel libro.
  • Ordini di crescita — Il confronto visivo tra i principali ordini di crescita.
  • Array e stringhe — Complessità delle operazioni su array e stringhe a colpo d'occhio.
  • Liste concatenate — Complessità delle operazioni sulle liste concatenate a colpo d'occhio.
  • Stack, code e deque — Complessità delle operazioni su stack, code e deque a colpo d'occhio.
  • Hash map e hash set — Complessità delle operazioni su hash map e hash set a colpo d'occhio.
  • Alberi di ricerca — Complessità delle operazioni su BST, AVL e Red-Black a colpo d'occhio.
  • Heap e priority queue — Complessità delle operazioni su heap e code a priorità a colpo d'occhio.
  • Trie — Complessità delle operazioni sul trie a colpo d'occhio.
  • Union-Find — Complessità delle operazioni sulla struttura union-find a colpo d'occhio.
  • Ricerca — Complessità dei principali algoritmi di ricerca a colpo d'occhio.
  • Ordinamento — Complessità dei principali algoritmi di ordinamento a colpo d'occhio.
  • Ricorsione e divide et impera — Complessità tipiche di algoritmi ricorsivi e divide et impera.
  • Grafi — Complessità degli algoritmi sui grafi a colpo d'occhio.
  • Backtracking — Complessità tipiche degli algoritmi di backtracking.
  • Algoritmi greedy — Complessità dei principali algoritmi greedy a colpo d'occhio.
  • Programmazione dinamica — Complessità tipiche degli algoritmi di programmazione dinamica.
  • Caching — Complessità delle operazioni su cache LRU e LFU a colpo d'occhio.
  • Ricerca su stringhe — Complessità degli algoritmi di ricerca su stringhe a colpo d'occhio.
BStrutture dati native di TypeScript/JavaScriptUna rassegna di cosa offre nativamente JavaScript e cosa invece va implementato da zero.
  • Perché JavaScript ha così poco di nativo — Perché il linguaggio offre solo alcune strutture dati pronte all'uso.
  • Array — Cosa offre nativamente l'array di JavaScript.
  • Liste concatenate — Perché JavaScript non ha liste concatenate native.
  • Stack, Queue e Deque — Come simulare stack, coda e deque con le strutture native.
  • Map e Set — Le strutture Map e Set native e le loro caratteristiche.
  • Alberi, heap, trie e grafi — Perché queste strutture vanno sempre implementate da zero in JavaScript.
CRisorse per continuareLibri, piattaforme e community per continuare ad approfondire algoritmi e strutture dati dopo la lettura.
  • Libri — Altri libri consigliati per approfondire l'argomento.
  • Piattaforme per esercitarti — I siti migliori dove esercitarti con problemi di coding.
  • Visualizzare gli algoritmi — Strumenti per visualizzare il funzionamento di algoritmi e strutture dati.
  • Community — Dove trovare community di sviluppatori con cui confrontarti.
  • Un ultimo consiglio — Un ultimo suggerimento per continuare a crescere come sviluppatore.

Costruisci oggi le basi per diventare uno sviluppatore migliore.

✦
Torna al catalogo